Enquête · Numérique & climat
Empreinte carbone de l’IA : quatre saisons de données
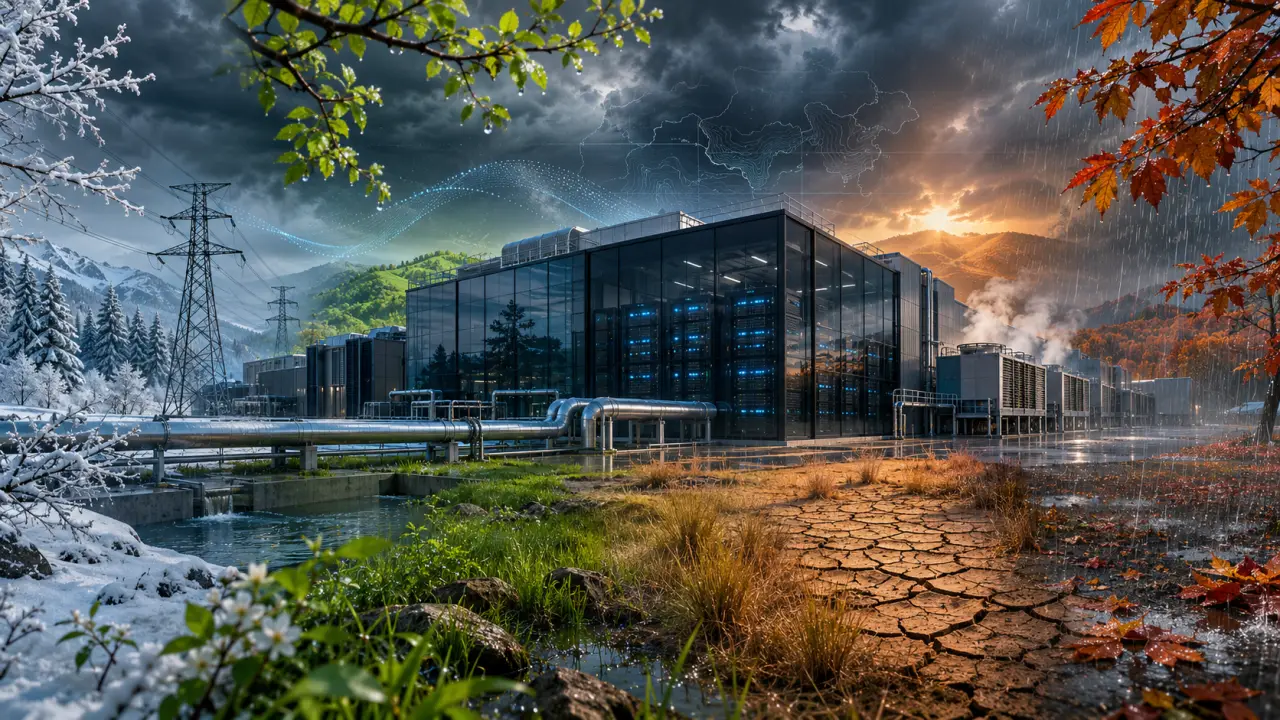
L’empreinte environnementale de l’intelligence artificielle n’est pas un chiffre fixe. Elle varie avec la demande, la météo, le lieu d’hébergement et le matériel mobilisé. Pour la comprendre, il faut suivre ses données au fil de l’année.
Combien de carbone émet une requête adressée à une IA générative ? La question semble appeler une réponse simple : un nombre de grammes, comparable d’un service à l’autre. Mais ce résultat dépend de paramètres rarement visibles dans l’interface. La taille du modèle, la longueur des réponses, le taux d’utilisation des serveurs et l’origine de l’électricité modifient le calcul. Une estimation isolée, sans méthode ni périmètre, renseigne peu sur l’impact réel.
Printemps : la demande sort de l’ombre
Au printemps, les entreprises accélèrent souvent leurs expérimentations : assistants internes, génération de code, traitement de documents ou création d’images. Cette montée en charge rend une première variable décisive : le volume d’inférences, autrement dit le nombre de fois où un modèle est sollicité après son entraînement.
Or, les usages ne se valent pas. Une courte question textuelle ne mobilise pas nécessairement les mêmes ressources qu’une analyse de plusieurs fichiers ou qu’une génération d’image. La durée de calcul, la quantité de données traitées et le matériel sollicité entrent en jeu. En outre, l’entraînement initial d’un modèle et son exploitation quotidienne sont deux postes distincts : les confondre empêche d’attribuer correctement les émissions.
Pour établir une comparaison utile, il faut donc rapporter l’impact à une unité de service clairement définie : une réponse de longueur donnée, une image produite ou une tâche accomplie. Il faut aussi documenter la qualité du résultat. Une réponse inutilisable, qui entraîne plusieurs nouvelles requêtes, peut alourdir le bilan sans rendre le service plus efficace.
Été : quand la chaleur pèse sur les centres de données
La saison chaude met en évidence un autre mécanisme : le refroidissement. Les serveurs dégagent de la chaleur et les centres de données doivent maintenir des conditions de fonctionnement compatibles avec leur matériel. Selon la conception du site et le climat local, les besoins de refroidissement peuvent varier sensiblement. Une vague de chaleur ne conduit pas partout aux mêmes conséquences, mais elle constitue un facteur à examiner plutôt qu’une note de bas de page.
Les exploitants publient parfois des indicateurs d’efficacité énergétique, comme le rapport entre l’énergie totale d’un centre et celle consommée par ses équipements informatiques. Cet indicateur est utile, mais il ne mesure pas à lui seul l’empreinte carbone. Deux installations également efficaces peuvent s’appuyer sur des réseaux électriques d’intensité carbone différente. Le lieu et l’heure de consommation comptent donc autant que le bâtiment.
Cette lecture par les usages rejoint des questions très concrètes de sobriété numérique : choisir un outil adapté, limiter les traitements redondants et examiner les besoins avant d’ajouter une solution automatisée. Dans d’autres domaines, des guides pratiques aident aussi à comparer des options et à mesurer leurs effets sur un budget ou une activité ; sur cette page, le principe utile reste le même : expliciter les critères avant de retenir un chiffre.
Automne : l’électricité change de couleur
La même charge informatique peut produire des émissions différentes selon le mix électrique disponible au moment où elle est exécutée. Une moyenne annuelle nationale ne décrit pas nécessairement la réalité d’une heure précise, ni celle d’un centre de données situé dans un autre pays. Les contrats d’approvisionnement en énergie renouvelable, eux aussi, doivent être interprétés avec prudence : leur existence ne prouve pas automatiquement que chaque kilowattheure consommé correspond à une production renouvelable supplémentaire au même endroit et au même moment.
Pour approcher cette complexité, les analystes distinguent souvent les facteurs d’émission moyens des facteurs marginaux. Les premiers répartissent les émissions du système sur l’ensemble de la consommation ; les seconds cherchent à estimer quelle production répond à une demande additionnelle. Ces méthodes ne répondent pas à la même question. Un article rigoureux doit indiquer laquelle il utilise, préciser la zone géographique et signaler les limites des données disponibles.
- le périmètre retenu : entraînement, inférence ou cycle de vie complet ;
- l’unité de comparaison et la tâche réellement accomplie ;
- la localisation et la période de consommation électrique ;
- les hypothèses sur le refroidissement, le matériel et son renouvellement.
Hiver : le matériel et les limites des chiffres
L’hiver ramène l’attention vers les équipements eux-mêmes. Les accélérateurs spécialisés, serveurs, réseaux et systèmes de stockage ont nécessité des matières premières, de l’énergie et des procédés industriels avant leur mise en service. Leur fabrication constitue une part de l’impact qui n’apparaît pas toujours dans les bilans opérationnels des centres de données. La durée de vie du matériel, son taux d’utilisation et les possibilités de réemploi influencent alors la répartition de ces émissions entre les services rendus.
Cette dimension est difficile à attribuer précisément à une requête. Un serveur peut héberger plusieurs applications, et les fabricants ne publient pas toujours des données détaillées sur la production de chaque composant. Les chiffres doivent donc être présentés comme des estimations assorties d’incertitudes, non comme des mesures universelles. Une fourchette documentée est souvent plus honnête qu’une décimale spectaculaire.
Rendre l’empreinte vérifiable
Pour enquêter, DataVox croise les déclarations des fournisseurs avec les données énergétiques publiques, les rapports d’entreprise et les travaux scientifiques. Les sources ne couvrent pas toutes les mêmes périodes ni les mêmes périmètres ; leur rapprochement exige de conserver les définitions d’origine et de rendre explicites les conversions. La visualisation peut ensuite faire apparaître les écarts : par région, par saison, par type de tâche ou selon les hypothèses de calcul.
Cette transparence est essentielle pour éviter deux raccourcis opposés : présenter l’IA comme immatérielle parce qu’elle s’utilise à l’écran, ou la réduire à une empreinte unique et définitive. Les usages peuvent apporter des bénéfices, par exemple en optimisant certains processus, mais ces gains doivent être démontrés et comparés à un scénario de référence. Une économie théorique ne compense pas automatiquement une consommation supplémentaire.
La prochaine étape consiste à obtenir des données plus granulaires et comparables : consommation par service, localisation des charges, efficacité du refroidissement et durée de vie des équipements. Tant que ces informations restent partielles, la meilleure enquête n’est pas celle qui promet un total absolu, mais celle qui montre ce que l’on sait, ce qui manque et comment ces inconnues influencent le résultat. Pour suivre nos autres analyses et visualisations, retrouvez la page d’accueil de DataVox.