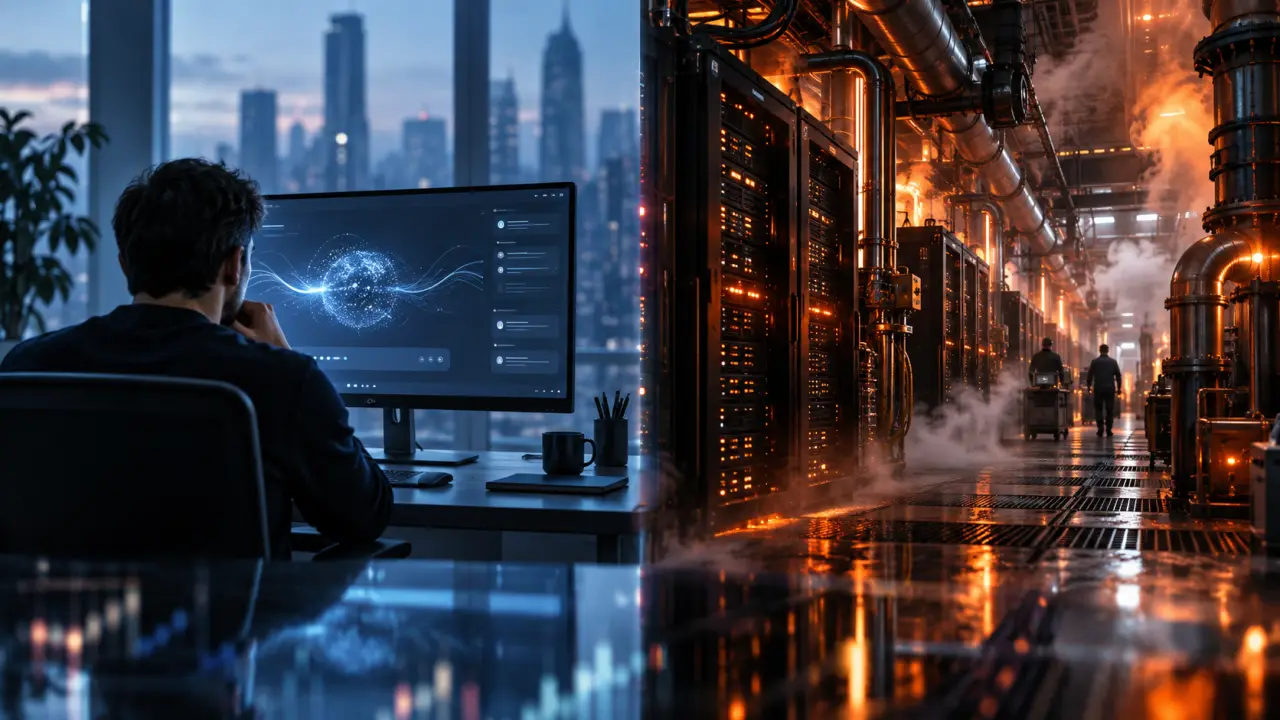
Une question posée à une intelligence artificielle ne ressemble qu’à une poignée de mots. Pourtant, derrière cette interaction presque instantanée se mobilisent des puces spécialisées, des serveurs refroidis en continu, des réseaux et une électricité dont l’intensité carbone varie fortement selon le lieu et l’heure. Le coût d’une requête n’est donc pas un chiffre unique : c’est une chaîne matérielle, énergétique et industrielle.
Le débat public oscille entre deux simplifications. D’un côté, l’idée qu’une requête serait négligeable parce qu’elle consomme peu d’électricité prise isolément. De l’autre, la tentation de lui attribuer systématiquement une empreinte spectaculaire. Pour comprendre le phénomène, il faut comparer deux moments : avant, quand un modèle est entraîné et déployé, et après, quand il répond à des millions d’utilisateurs.
Avant la réponse : le poids invisible de l’entraînement
L’entraînement est l’étape la plus visible dans les bilans communiqués par les opérateurs. Pendant plusieurs semaines ou plusieurs mois, des milliers de processeurs exécutent des calculs sur d’immenses volumes de textes, d’images ou de codes. Leur consommation dépend de la taille du modèle, de la durée des calculs, du rendement des centres de données et du mix électrique local.
À cette première dépense s’ajoute celle des essais successifs. Un modèle n’est pas entraîné une seule fois : les équipes testent des architectures, corrigent des jeux de données, recommencent certains cycles et évaluent les résultats. Les chiffres disponibles sont souvent incomplets, car les entreprises publient rarement la totalité des paramètres nécessaires à une vérification indépendante.
Le point aveugle : une estimation crédible doit distinguer l’énergie consommée de l’empreinte carbone. Un kilowattheure produit par une centrale hydraulique et un kilowattheure issu d’une centrale à gaz ne portent pas le même impact climatique.
Il faut encore compter la fabrication des équipements. L’extraction des minerais, la production des semi-conducteurs, l’assemblage des serveurs et leur transport forment une « empreinte incorporée ». Elle est difficile à attribuer à chaque requête, mais elle existe : plus les machines sont renouvelées rapidement, plus cette part pèse dans le bilan global.
Après : quand l’usage devient le principal multiplicateur
Une fois le modèle disponible, chaque réponse mobilise une fraction de ces infrastructures. La dépense unitaire dépend de la longueur de la demande, de la quantité de texte générée, du modèle sollicité et du type de tâche. Une courte classification n’a pas le même profil qu’une analyse documentaire accompagnée de plusieurs générations d’images.
La comparaison « une requête contre une recherche web » est par conséquent fragile. Elle peut être pertinente pour illustrer un ordre de grandeur, mais elle ne tient pas toujours compte du nombre de résultats consultés, de la longueur de la réponse, du matériel utilisé ou du fait qu’une recherche classique peut déclencher elle aussi des calculs complexes.
Trois variables qui font varier le résultat
- Le modèle : les versions les plus puissantes mobilisent généralement davantage de calculs, même si l’optimisation peut réduire la consommation par opération.
- La requête : un long contexte et une réponse volumineuse augmentent le nombre de jetons traités.
- Le centre de données : son efficacité énergétique et son approvisionnement électrique modifient directement l’empreinte carbone.
À l’échelle individuelle, l’écart paraît parfois faible. À l’échelle d’un service utilisé en continu, il devient structurel. Un assistant intégré à un moteur de recherche, un logiciel professionnel ou un smartphone peut transformer des milliards d’interactions dispersées en une demande énergétique comparable à celle d’une infrastructure industrielle.
Le bon indicateur n’est pas seulement le coût d’une réponse, mais le coût d’un usage multiplié par sa fréquence et par le nombre de personnes concernées.
Cette logique de volume vaut aussi pour les usages numériques qui prolongent un geste du quotidien. Lorsqu’un lecteur compare des soins, des pratiques de bien-être ou des produits, la sobriété ne consiste pas à supprimer toute recherche, mais à privilégier une information utile, durable et vérifiable. Bambloo observe ainsi les tendances de l’art de vivre et de la beauté en les replaçant dans des pratiques concrètes, plutôt qu’en encourageant l’accumulation de recommandations automatisées.
Avant/après : ce que changent les optimisations
Le scénario « avant » correspond à un modèle peu optimisé, utilisé pour toutes les tâches, avec des réponses longues et un centre de données alimenté par une électricité carbonée. Le scénario « après » combine un modèle adapté à la difficulté réelle, une réponse concise, une mise en cache des résultats fréquents et un fonctionnement dans une région où l’électricité est moins émettrice.
Le gain ne vient pas d’un seul levier. La compression des modèles, la mutualisation des calculs et l’amélioration du refroidissement peuvent réduire l’énergie nécessaire à une opération. La programmation de certaines tâches aux heures où l’électricité est moins carbonée peut aussi améliorer le bilan, à condition de ne pas déplacer simplement la consommation vers un autre réseau sous tension.
Les utilisateurs ont également une marge d’action, sans que la responsabilité puisse leur être entièrement transférée :
- choisir un modèle proportionné à la tâche ;
- éviter les régénérations répétées lorsque la première réponse suffit ;
- fournir un contexte précis pour limiter les échanges inutiles ;
- réserver les modèles lourds aux tâches qui justifient réellement leur calcul.
Mesurer plutôt que promettre
Pour passer du discours aux faits, les fournisseurs devraient publier une méthode reproductible : énergie par requête, longueur moyenne des réponses, localisation des calculs, efficacité des centres de données et hypothèses retenues pour la fabrication des serveurs. Sans ces informations, les comparaisons restent des estimations, parfois utiles pour sensibiliser, mais insuffisantes pour piloter une politique climatique.
Les pouvoirs publics et les chercheurs peuvent, eux, croiser les déclarations des opérateurs avec les données d’électricité, les capacités installées et les volumes d’usage. Cette approche permet de repérer les écarts entre la performance annoncée d’un modèle et l’empreinte réelle d’un service déployé à grande échelle. Elle rappelle également que l’enjeu ne se limite pas au carbone : eau de refroidissement, matériaux, déchets électroniques et pression sur les réseaux comptent aussi.
Le véritable « après » ne sera donc pas une promesse de neutralité. Ce sera une mesure plus transparente, des modèles mieux dimensionnés et des usages évalués par leur utilité sociale autant que par leur nouveauté. Pour suivre ces transformations à partir des chiffres, découvrez les analyses de notre page d’accueil.